


本文为 Python 60 Days Challenge 课程学习整理,原作者与原 Notebook 链接见「课程资料」。代码按章节顺序运行;语法示意和故意报错的反例已单独标注。
数据准备: 将课程仓库中的 data.csv/data.xlsx 放在 Notebook 的当前工作目录,路径已移除原作者电脑的盘符。读取 Excel 需要 openpyxl。各节额外依赖按文中安装说明准备。
本次校订: 手动整数映射会引入人为顺序,不能据此把标称类别解释为连续量。归一化示例用于认识 API;建模时仅在训练集 fit,常数列要避免除以零。
打卡任务
- 阅读本节讲义或 Notebook
- 跑通示例代码
- 整理 3 个关键点
- 完成当日打卡输出
课程资料
- 训练营讲义:https://docs.qq.com/doc/DTFhndExSRGNHS3B6?nlc=1
- GitHub 仓库:https://github.com/cheer932041235/Python60DaysChallenge
- 本日 Notebook:Day8 标签编码与连续变量处理.ipynb
学习内容
1.1 字典的简单介绍
可以去b站找个视频 或者 csdn找个帖子看下字典的简单介绍----锻炼下自学能力
但是目前我们只会用到映射这个用法,他需要传入的是字典,因为字典的键值对,键是唯一的,值可以重复。这很符合数据的特征是固定的,但是值可以变化这个特性。
所以后续想完成新的映射,直接修改字典的键值对即可。
提示: 字典是Python中非常重要的数据结构,在数据处理中经常用于映射和转换。
字典的性质:
- 可变类型: 字典创建后可以修改、添加或删除键值对
- 键的唯一性: 字典中的键必须是唯一的,重复的键会被覆盖
- 键的不可变性: 键必须是不可变类型(如字符串、数字、元组),不能用列表做键
- 值的任意性: 值可以是任何数据类型,可以重复
# 使用花括号创建字典
my_dict = {'name': 'Alice', 'age': 25, 'city': 'New York'}

my_dict
# 访问字典中的值(查)
my_dict['name']  # 访问字典中的值
# 修改字典中的值(改)
my_dict['age'] = 26  # 修改年龄
my_dict
# 添加新的键值对(增)
my_dict['job'] = 'Engineer'  # 添加新键值对
my_dict
# 删除键值对(删)
del my_dict['city']  # 删除city这个键值对
my_dict
1.2 标签编码
之前介绍了离散数据 如果是不存在顺序,则采用独热编码,函数为pd.get_dummies()
现在介绍对于存在顺序和大小关系的离散特征,做好标签编码,借助dataframe的map函数即可实现
关键点: 标签编码适用于有序分类变量,可以保留变量之间的大小关系。
# 导入库并读取数据
import pandas as pd
data = pd.read_csv('data.csv')
# 查看数据前几行
data.head()
1.2.1 Home Ownership特征编码
这里我们给Home Ownership来完成标签编码,实际上这个特征也可以独热编码,取决于你的理解。实际中,都试一下,谁训练出来的模型好选谁。
# 查看Home Ownership特征的分布
data["Home Ownership"].value_counts()
数据含义解读:
- 住房抵押贷款(Home Mortgage): 3637 这个是有房贷,有房子
- 租房(Rent): 3204 没房子
- 拥有自有住房(Own Home): 647 这个没贷款,有房子,没房贷
- 有贷款(Have Mortgage): 12 这个是有其他贷款,有房子,没房贷
上面这些翻译也不一定对,这是我个人对数据的理解。
按照贷款严重程度(抗风险能力),依次是: 自有住房 < 租房 < 有其他贷款 < 住房抵押贷款
所以按照这个逻辑来进行编码,数字越大表示负债压力越大。
# 定义映射字典
mapping = {
        "Own Home": 0,
        "Rent": 1,
        "Have Mortgage ": 2,
        "Home Mortgage": 3

}
data["Home Ownership"].head()
# 应用映射并查看结果
data["Home Ownership"] = data["Home Ownership"].map(mapping)
data["Home Ownership"].head()
# 查看Term特征的分布
data["Term"].value_counts()
1.2.2 Term特征编码
对于字符串类型我们也要映射成整数类型,这里不要理解为标签编码或者独热编码
我们在复试班说过,二分类的问题不需要独热编码,比如性别这个特征,男女不需要变成2个特征(性别男、性别女)。因为他们二者自由度为1,如果是2个特征的话,性别男=1,那么性别女必定等于0。这样特征高度相关,没有价值。
此时这个特征的含义不是性别,而是:是否为男性,1是男性,0是非男。
记住: 三分类以上才涉及独热编码
# 对Term特征进行映射
# 定义映射字典
mapping = {
    "Short Term": 1,
    "Long Term": 0
}

# 进行映射
data["Term"] = data["Term"].map(mapping)
data["Term"].head()
1.2.3 使用嵌套字典批量映射
实际上借助一个映射函数也可以实现上面2次编码
字典的键值对可以嵌套字典,这样可以把多个特征的映射规则集中管理,代码更简洁。
# 创建嵌套映射字典
import pandas as pd

# 重新读取数据
data = pd.read_csv('data.csv')
# 嵌套映射字典
mapping = {
    "Term": {
        "Short Term": 1,
        "Long Term": 0
    },
    "Home Ownership": {
        "Rent": 0,
        "Own Home": 1,
        "Have Mortgage  ": 2,
        "Home Mortgage": 3
    }
}
# 访问嵌套字典
mapping["Term"] # 访问嵌套字典中的值,此时他又是一个字典
# 批量应用映射
# 对 Home Ownership 列进行映射
data["Home Ownership"] = data["Home Ownership"].map(mapping["Home Ownership"])

# 对 Term 列进行映射
data["Term"] = data["Term"].map(mapping["Term"])

data.head()
1.3 连续变量的处理
归一化和标准化可以通过手写函数实现,也可以使用sklearn中的归一化和标准化函数。
为什么需要处理连续变量? 不同特征的量纲和数值范围差异很大,会影响模型训练效果,需要进行归一化或标准化处理。
1.3.1 归一化与标准化的区别
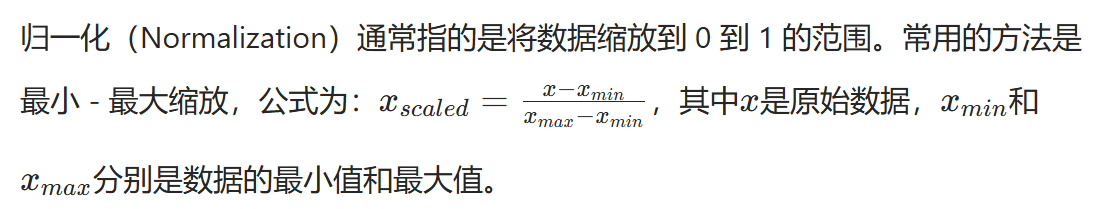
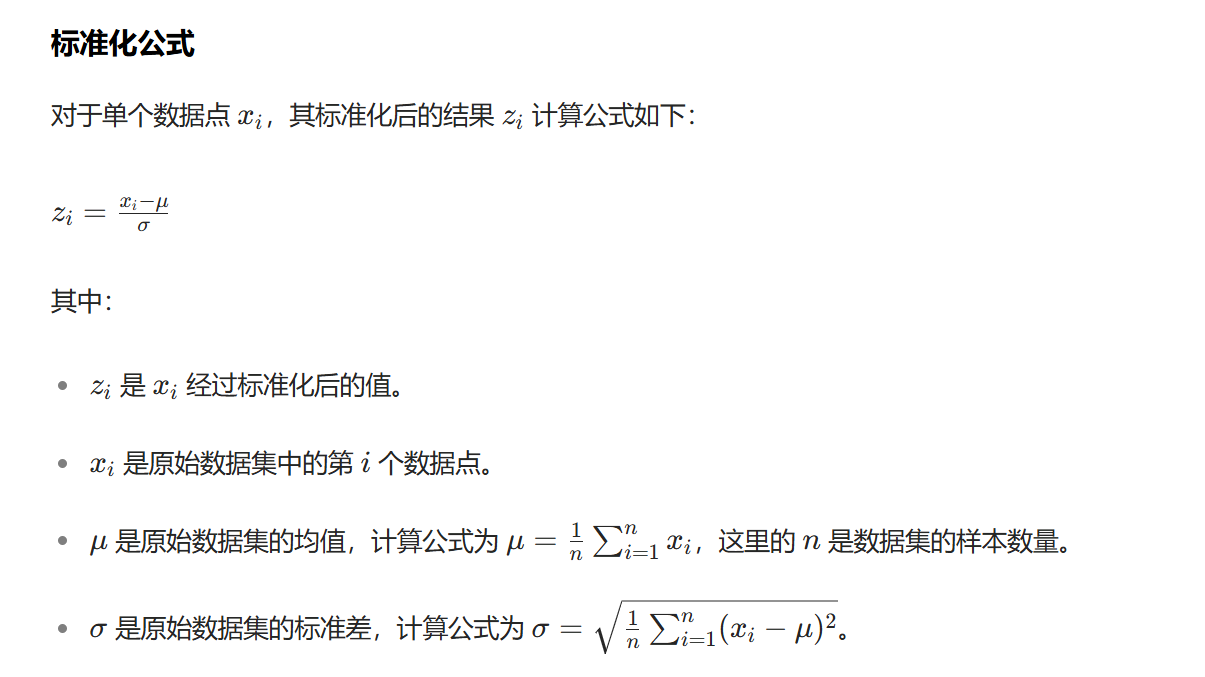
归一化: 将数据缩放到[0,1]区间
标准化: 将数据转换为均值为0,标准差为1的分布
# 手动实现归一化
# 对Annual Income列做归一化,手动构建函数实现
# 自行学习下如何创建函数,这个很简单很常用
def manual_normalize(data):
    """
    此函数用于对输入的数据进行归一化处理
    :param data: 输入的一维数据(如 Pandas 的 Series)
    :return: 归一化后的数据
    """
    min_val = data.min()
    max_val = data.max()
    normalized_data = (data - min_val) / (max_val - min_val)
    return normalized_data
data['Annual Income'] = manual_normalize(data['Annual Income'])
data['Annual Income'].head()
# 使用sklearn进行归一化处理
# 借助sklearn库进行归一化处理

from sklearn.preprocessing import StandardScaler, MinMaxScaler
data = pd.read_csv('data.csv')# 重新读取数据


# 归一化处理
min_max_scaler = MinMaxScaler() # 实例化 MinMaxScaler类,之前课上也说了如果采取这种导入函数的方式,不需要申明库名
data['Annual Income'] = min_max_scaler.fit_transform(data[['Annual Income']])

data['Annual Income'].head()
# 使用sklearn进行标准化处理
# 标准化处理
data = pd.read_csv('data.csv')# 重新读取数据
scaler = StandardScaler() # 实例化 StandardScaler
data['Annual Income'] = scaler.fit_transform(data[['Annual Income']])
data['Annual Income'].head()
Day8 标签编码与连续变量处理
本文采用 CC BY-NC-SA 4.0 许可协议,转载请注明出处。
评论交流
欢迎留下你的想法